Fehlerdiagnose ohne Maus: Wie sich ein mehrfacher Software-Absturz per PowerShell aufklären lässt
Ein reales IT-Support-Fallbeispiel: Sidexis-4-Abstürze bei einem Praxis-Kunden per Kommandozeile statt Ereignisanzeige aufgeklärt.
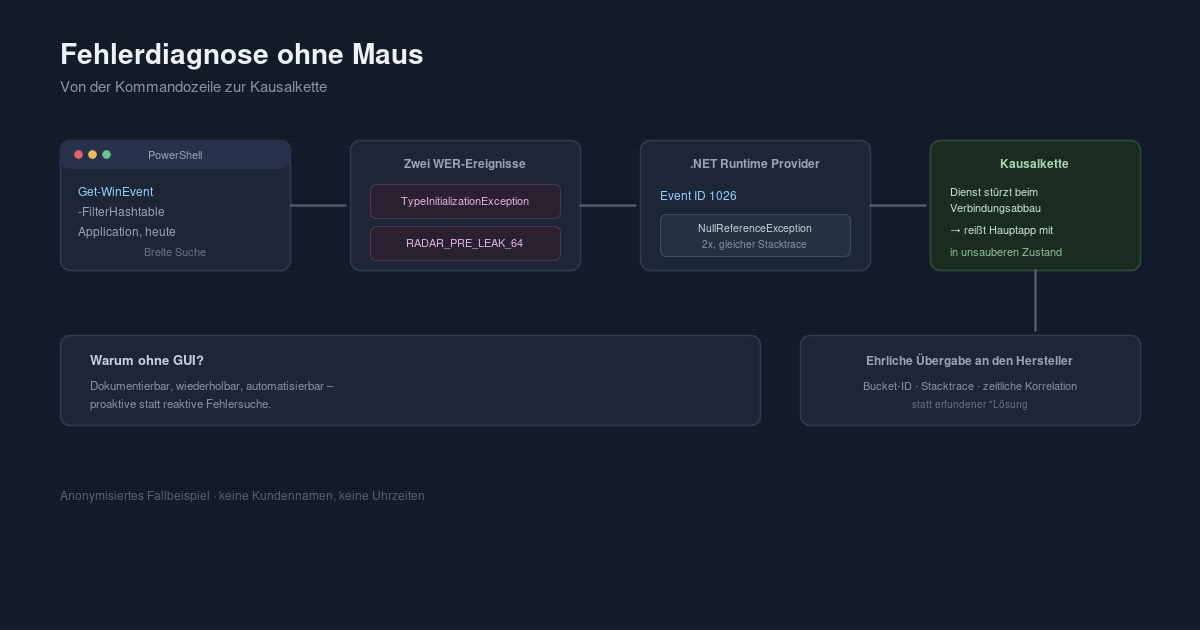
Ein Kunde aus dem Gesundheitswesen meldete sich mit einem inzwischen vertrauten Satz: "Die Software stürzt heute schon mehrfach ab." Konkret ging es um Sidexis 4, die verbreitete Bildgebungssoftware für zahnärztliche Röntgenaufnahmen, auf einer Workstation in der Praxis. Der Wunsch des Kunden war ausdrücklich: keine grafische Oberfläche, keine Ereignisanzeige-Klickerei – die Auswertung sollte sich vollständig über die Kommandozeile erledigen lassen. Ein guter Anlass, den kompletten Weg einmal aufzuschreiben.
Der Ausgangspunkt
Statt uns durch die Ereignisanzeige zu klicken, haben wir uns per Fernwartung auf ein administratives Terminal des betroffenen Rechners verbunden und direkt mit PowerShell gearbeitet. Der erste Schritt war eine breite Suche im Application-Eventlog nach allem, was mit dem Softwarenamen zu tun hat:
Get-WinEvent -FilterHashtable @{LogName='Application'; StartTime=(Get-Date).Date} |
  Where-Object { $_.Message -like '*Sidexis*' -or $_.Message -like '*XG3D*' } |
  Select-Object TimeCreated, Id, LevelDisplayName, ProviderName, Message |
  Format-List
Get-WinEvent mit einer FilterHashtable ist dabei deutlich schneller als das ältere Get-EventLog, weil die Filterung serverseitig im Eventlog-Index passiert und nicht erst nach dem Einlesen aller Einträge. Für einen ersten Überblick über nur einen Tag reicht das völlig.
Die Fundstelle
Aus dem vollständigen Dump ließen sich mit einem einfachen findstr auf die relevanten Zeilen die eigentlichen Kernfakten herausfiltern:
findstr /c:"TimeCreated" /c:"P1:" /c:"P9:" sidexis_log.txtErgebnis: zwei separate Windows-Error-Reporting-Einträge am selben Tag. Einmal der Prozess sidexisxraylauncher.exe mit einer System.TypeInitializationException, einmal der Hauptprozess Sidexis4.exe mit einem WER-Bucket namens RADAR_PRE_LEAK_64.
Eine TypeInitializationException ist laut .NET-Dokumentation praktisch immer ein Folgefehler: Der statische Konstruktor einer Klasse schlägt fehl, meist weil eine Abhängigkeit fehlt, eine Konfigurationsdatei nicht lesbar ist oder sich etwas in der Ausführungsumgebung geändert hat. Die eigentliche Ursache steckt fast immer in der InnerException – ein guter Hinweis, an dieser Stelle tiefer zu bohren, statt die Meldung für bare Münze zu nehmen.
RADAR_PRE_LEAK_64 wiederum ist kein klassischer Crash-Code, sondern ein heuristischer Windows-Bucket, der bei ungewöhnlich hohem oder lange gehaltenem Speicherverbrauch vergeben wird – unabhängig vom konkreten Programm. Er sagt für sich genommen wenig über die Ursache aus, ist aber ein Indiz dafür, dass der Prozess in diesem Moment auffällig viel Speicher gebunden hatte, bevor er beendet wurde.
Der zweite Blick: die .NET-Runtime selbst
Weil ein Bildgebungsprogramm wie Sidexis im Hintergrund auf einen Windows-Dienst für die Gerätekommunikation angewiesen ist, lohnte sich eine zweite, gezielte Abfrage – diesmal direkt auf den .NET-Runtime-Provider, der unbehandelte Exceptions dokumentiert:
Get-WinEvent -FilterHashtable @{LogName='Application'; StartTime=(Get-Date).Date; ProviderName='.NET Runtime'} |
  Select-Object TimeCreated, Id, Message |
  Format-List
Und tatsächlich: Der zugehörige Hintergrunddienst der Röntgengeräte-Anbindung war am selben Nachmittag zweimal mit derselben NullReferenceException abgestürzt – exakt im selben Stack, beim Schließen einer REST-Verbindung (ResetConnectionPool → CloseIntern). Kurz nach dem zweiten dieser Dienstabstürze folgte der Absturz der Hauptanwendung.
Das Gesamtbild
In der Zusammenschau ergab sich eine plausible Kausalkette: Ein Hintergrunddienst für die Sensorkommunikation hatte ein Problem beim Verbindungsabbau, stürzte deshalb wiederholt ab – und riss die Hauptanwendung kurz darauf mit in einen unsauberen Zustand, aus dem heraus sie ebenfalls beendet wurde. Der frühere Absturz des Launcher-Prozesses am selben Tag mit der Initialisierungs-Exception passt ins Bild eines insgesamt instabilen Zusammenspiels zwischen Anwendung und Gerätedienst.
Die Grenze der Selbsthilfe
An dieser Stelle haben wir bewusst öffentlich recherchiert, bevor wir eine Ferndiagnose als "gelöst" verkauft hätten. Für generische .NET-Fehlerbilder wie TypeInitializationException oder NullReferenceException gibt es reichlich Dokumentation – für die konkreten internen Klassennamen und Fehlerbucket-IDs proprietärer Praxissoftware naturgemäß nicht. Das ist keine Ausnahme, sondern der Normalfall bei Speziallösungen für einzelne Branchen: Die öffentliche Recherche liefert Kontext und Einordnung, ersetzt aber nicht den Herstellersupport, sobald es um interne Implementierungsdetails geht.
Am Ende stand deshalb keine erfundene "Lösung", sondern eine ehrliche, präzise formulierte Übergabe an den Softwarehersteller: Prozess- und Fehlerbucket-IDs, exakter Stacktrace, zeitliche Korrelation zwischen Dienst- und Anwendungsabsturz – alles, was ein Herstellersupport braucht, um das Ticket nicht neu diagnostizieren zu müssen, sondern direkt einzuordnen.
Warum der Weg über die Kommandozeile
Der Verzicht auf die grafische Ereignisanzeige war hier kein Selbstzweck. Wer die Filterung als PowerShell-Befehl formuliert, kann sie exakt dokumentieren, wiederholen und bei Bedarf automatisieren – etwa als wiederkehrende Prüfung, die auffällige Abstürze künftig proaktiv meldet, statt dass sie erst auffallen, wenn sich jemand in der Praxis beschwert. Genau das ist am Ende der Unterschied zwischen reaktivem und vorausschauendem IT-Support.
Dieser Beitrag beschreibt ein anonymisiertes, reales Fallbeispiel aus unserem IT-Support-Alltag. Konkrete Kundennamen, Gerätebezeichnungen und Uhrzeiten wurden entfernt oder verallgemeinert.